Alle indsigter

Sådan bliver jeres modebilleder til modevideoer med AI

Fire produktbilleder blev til en modevideo på 16 sekunder på én arbejdsdag. Se de fire trin, hvad der gik galt med start- og slutbilleder, hvor tøjet afveg, og hvem der skal mærke resultatet i EU.

Kenneth Dosanjh
Co-founder / Creative Director, AI Vidia · Lektor, Erhvervsakademi København

Produktbilleder af tøj bliver til en kort modevideo i fire trin: lås én identitetsreference, skift kun tøjet på ét godkendt masterbillede, generér hver kamerabevægelse ud fra et startbillede alene, og skjul hvert tøjskift i et kameradyk i klipningen. AI Vidias film på 16 sekunder, som gennemgangen herunder viser, blev lavet sådan ud fra fire produktbilleder på én arbejdsdag, uden filmhold, location eller model på settet.

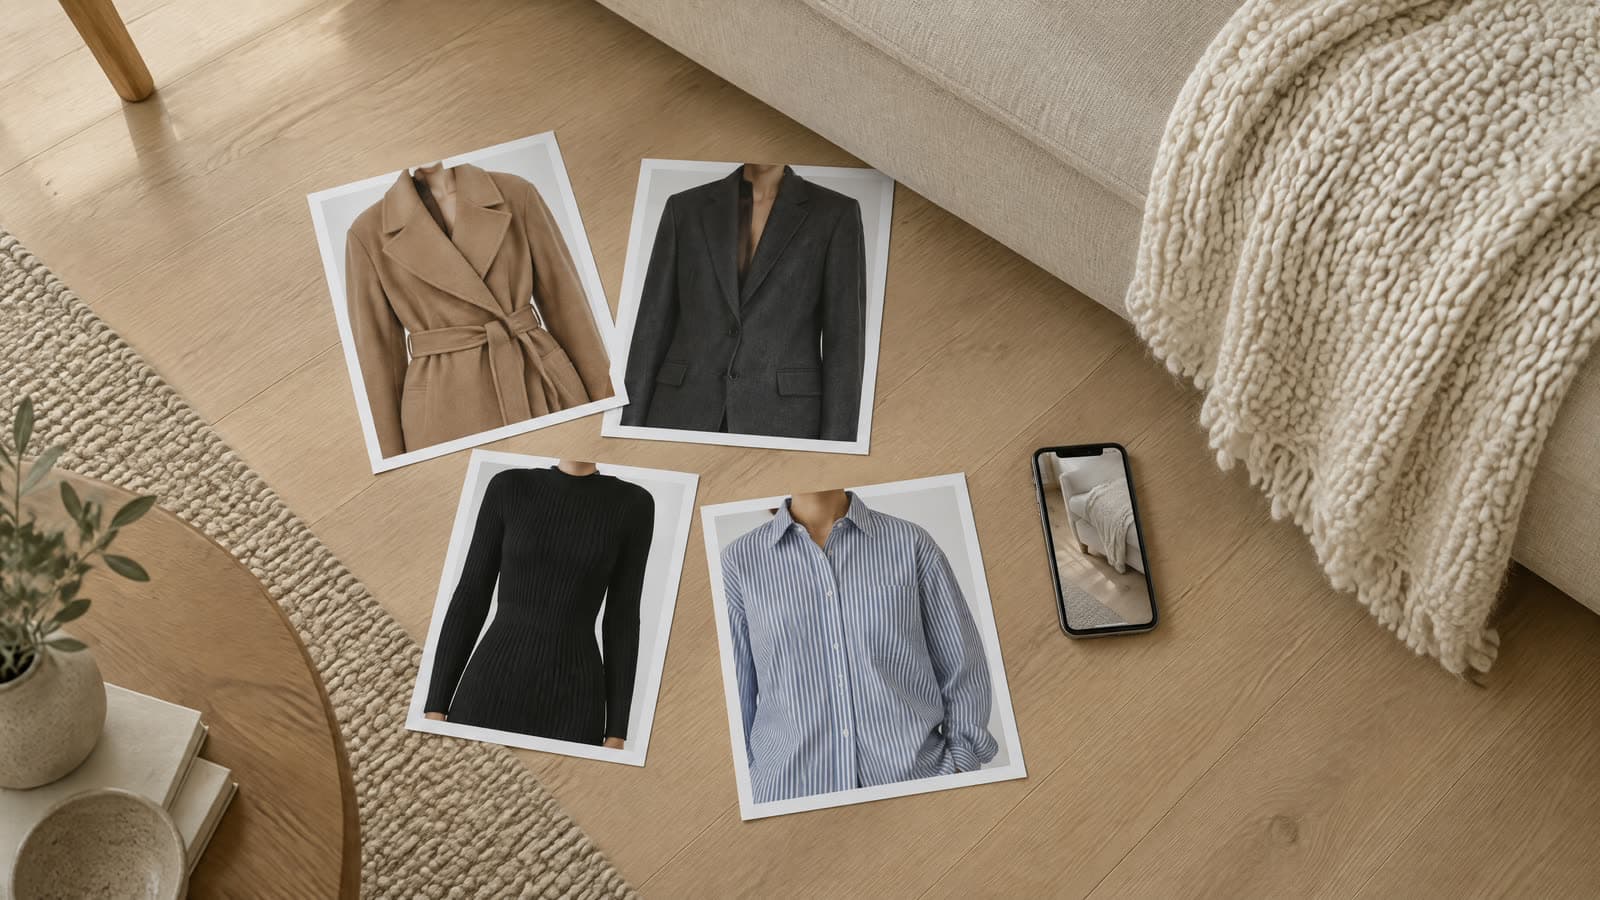
Fire udprintede produktbilleder af en kamelfarvet frakke, en koksgrå blazer, en sort strikkjole og en stribet skjorte på et egetræsgulv ved en hørsofa og en telefon
Billedet er genereret med AI: fire tøjbilleder uden hoveder ved sofaen, råmaterialet til en video, hvor tøjet skifter.
På denne side9 afsnit
  1. 01Video hører hjemme i et modebrands annoncer, med én undtagelse
  2. 02Hvad holder modebrands tilbage fra at lave mere video
  3. 03Trin 1: lås personen, før noget tøj findes
  4. 04Trin 2: byg én kulisse, og skift kun tøjet
  5. 05Trin 3: generér kamerabevægelsen ud fra et startbillede alene
  6. 06Trin 4: skjul hvert tøjskift i klipningen
  7. 07Hvor AI-tøjet afviger fra det rigtige stykke tøj
  8. 08Hvem skal mærke en AI-modevideo i EU
  9. 09Sådan tester I AI-modevideoer mod jeres stillbilleder

Fire produktbilleder af tøj kan blive til en lodret modevideo på 16 sekunder på én arbejdsdag, uden filmhold, location eller model på settet. Metoden har fire trin: lås én person, skift tøjet på ét masterbillede, generér hver kamerabevægelse ud fra et startbillede alene, og skjul hvert tøjskift i klipningen. AI Vidias gennemgangsfilm viser hvert trin, og afsnittene herunder vurderer, hvor stærk dokumentationen er for at arbejde sådan.

Filmen er et spec-projekt. Tøjet kommer fra en modekædes offentlige produktbilleder, kæden har ingen tilknytning til AI Vidia, og personen i filmen er en AI-avatar af Kenneth Dosanjh, medstifter af AI Vidia, lavet ud fra hans eget karakterark og med hans samtykke.
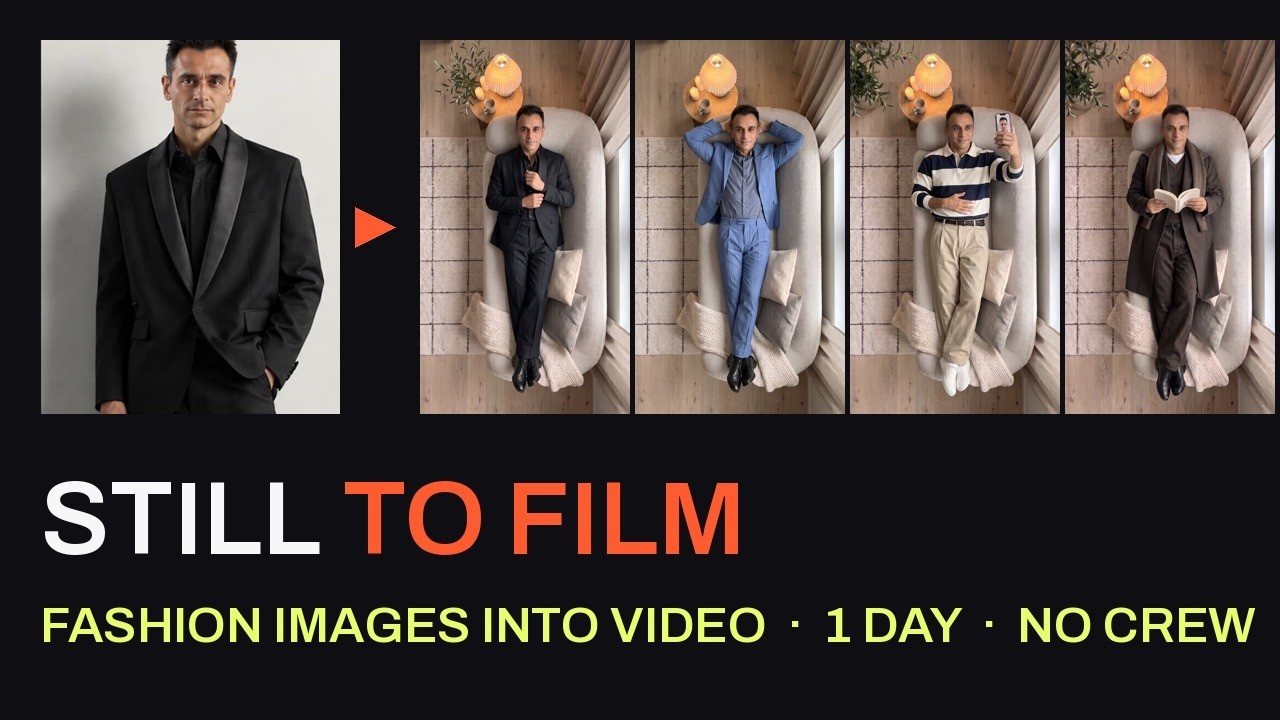
Titelkort fra AI Vidias gennemgangsfilm: et studieportræt af en mand i sort jakkesæt, en pil og fire billeder ovenfra af den samme mand liggende på en sofa i fire forskellige outfits
Gennemgangsfilmen, 5 minutter og 49 sekunder: se den på AI Vidias YouTube-kanal. Den viser modevideoen på 16 sekunder og hvert trin herunder. Personen i filmen er en AI-avatar af Kenneth Dosanjh, brugt med hans samtykke; billeder og speak er lavet med AI.
De fire trin i overblik: hvad der går ind, hvad der kommer ud, og hvilken fejl hvert trin forhindrer
TrinInputOutputFejl, trinnet forhindrer
1. Lås personenForfra, profil og nærbillede af ét ansigtÉt godkendt masterbilledeEt lidt anderledes ansigt i hvert outfit
2. Skift kun tøjetMasterbilledet plus produktbilleder beskåret ved kravenÉt billede pr. outfit med samme kulisse og lysFire outfits, der ligner fire fremmede
3. Kun startbilledeÉt billede pr. outfitÉn sammenhængende kamerabevægelse pr. outfitEn overtoning eller et hårdt klip i stedet for en bevægelse
4. Skjul skiftetKlippene og et musiknummerÉn lodret film klippet på beatetEt synligt hop, når tøjet skifter

Video hører hjemme i et modebrands annoncer, med én undtagelse

Den stærkeste dokumentation er en række laboratoriestudier. Anne Roggeveen, Dhruv Grewal, Claudia Townsend og R. Krishnan viste i Journal of Marketing (2015), at når et produkt blev vist på video i stedet for som stillbillede, steg valget af den mest hedoniske mulighed med mere end 79 procent på tværs af deres studier. Video trækker folk ind i oplevelsen af produktet, næsten som når de bruger det. Tøj er et hedonisk køb.

Platformenes egne tal peger samme vej. På Metas regnskabsopkald for første kvartal 2026 den 29. april 2026 sagde Mark Zuckerberg, at video driver rekordhøjt engagement på Facebook og Instagram. Finansdirektør Susan Li fortalte, at forbedringer i rangeringen gav 10 procent mere tid brugt på Reels på Instagram, og at den samlede videotid på Facebook voksede mere end 8 procent i forhold til kvartalet før. Det er tal om opmærksomhed, oplyst af platformen selv. De siger intet om salg.

Annonceresultaterne rummer undtagelsen. ATTN Agency offentliggjorde i marts 2026 benchmarks for Meta, som Segwise senere citerede: Video havde den højeste klikrate, og stillbilleder havde den laveste pris pr. køb (CPA). ATTN oplyser hverken metode eller datagrundlag for tallene, så læs dem som ét bureaus tal.

Meta-benchmarks for video- og stillbilledannoncer ifølge ATTN Agency, marts 2026 (oplyst af bureauet; metode og datagrundlag ikke offentliggjort)
MåltalVideoStillbillede
Klikrate1,9 %1,1 %
Pris pr. køb (CPA)48,20 USD34,50 USD

Samlet set taler dokumentationen for video over for folk, der aldrig har set brandet. Stillbilleder beholder deres plads over for dem, der allerede kender det. Den opdeling former testen i sidste afsnit.

Hvad holder modebrands tilbage fra at lave mere video

De fleste virksomheder laver allerede noget video. I Wyzowls undersøgelse af videomarkedsføring for 2026 svarede 91 procent af virksomhederne, at de bruger video. Blandt dem, der ikke gør, var de hyppigste grunde, at video ikke er nødvendigt, eller at det er for dyrt, med 24 procent hver, efterfulgt af mangel på tid med 19 procent.

Mode har en skarpere udgave af prisproblemet. En optagelse kræver en model, et filmhold, en location og ugers planlægning, og hvert nyt look starter forløbet forfra. Et brand, der lancerer nye styles hver måned, må enten booke flere optagelser eller lade de fleste nye styles stå som stillbilleder.

Genereret video ændrer, hvad ét look koster. Udgangspunktet er produktbilleder, som brandet allerede ejer, og et nyt look er en ny generering uden en ny optagelse. Dermed kommer en test med ti looks inden for rækkevidde af et budget, der aldrig kunne betale en optagelse med ti looks. AI Vidia laver dem som AI-videoannoncer til Meta, TikTok og YouTube, leveret i 9:16.

Trin 1: lås personen, før noget tøj findes

Hvert billede afhænger af én identitetsreference: et billede forfra, et profilbillede og et nærbillede af ansigtet. Personen i filmen er bygget ud fra Kenneths eget karakterark, den samme slags låste reference, som ligger bag en AI-talsperson eller en fast præsentationsvært for et brand.

De første forsøg i produktionen gav et lidt forskelligt ansigt i hvert sæt tøj. At reparere ansigterne gjorde dem værre, fordi hver rettelse blev et kompromis mellem to ansigter. Det virkede at starte forfra. Holdet valgte ét godt billede af personen, godkendte det som master og genererede hvert senere sæt tøj ud fra netop det billede og intet andet.
Har I brug for nye annoncer?
Beskriv jeres produkt og det, I vil afprøve.
Send jeres brief

Trin 2: byg én kulisse, og skift kun tøjet

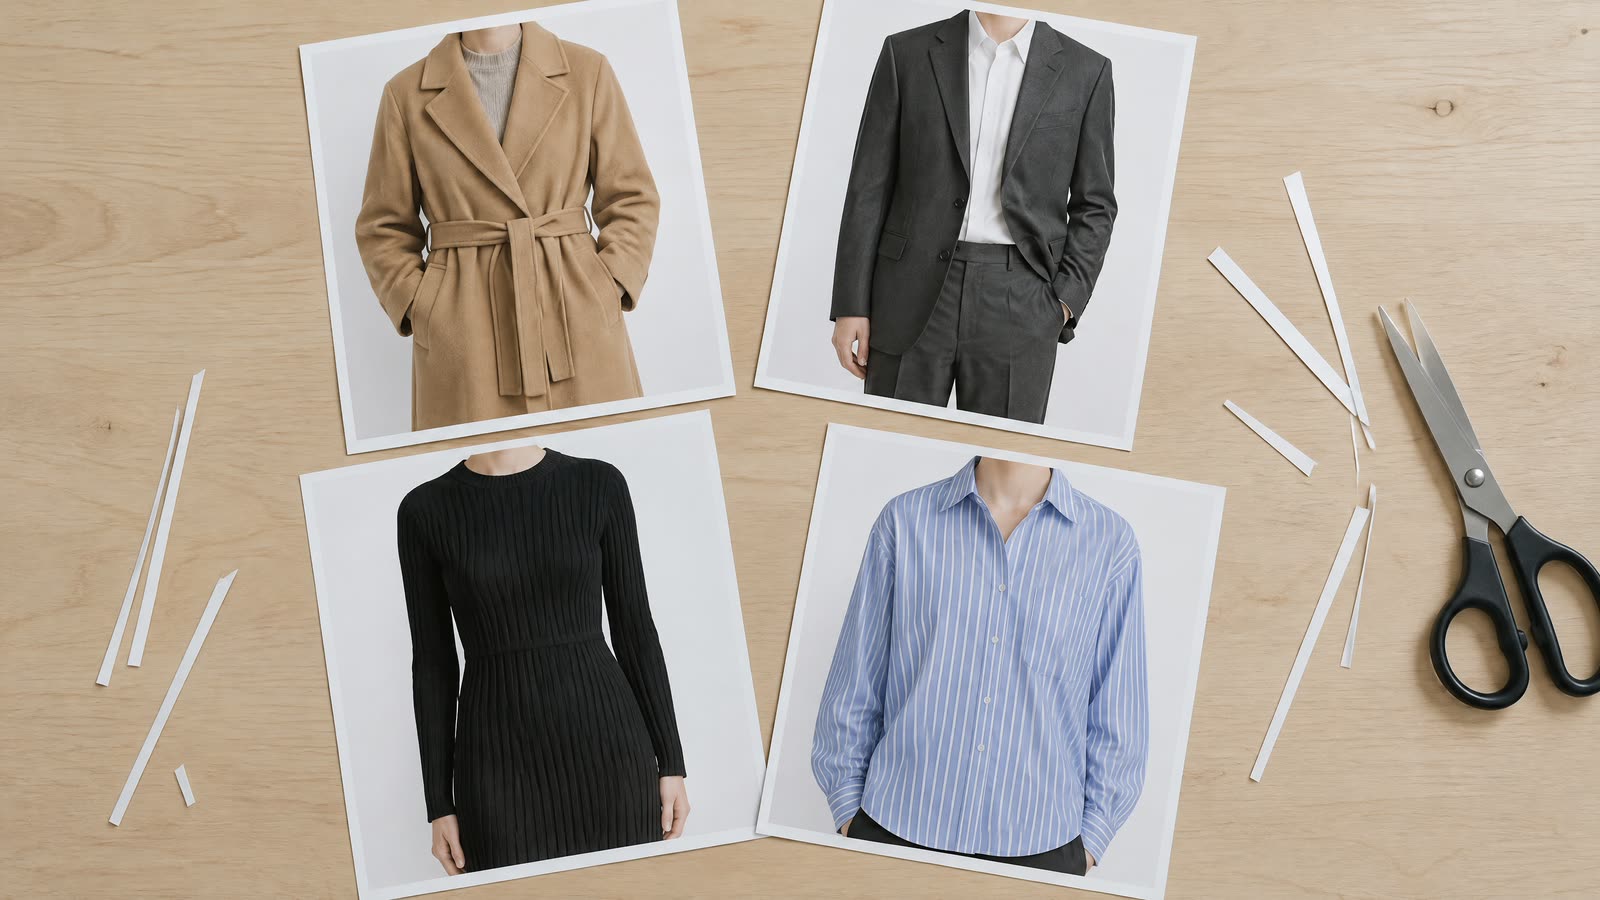
Kulissen er én rolig skandinavisk stue set ovenfra, med personen liggende på en sofa. Før produktbillederne blev brugt som tøjreferencer, blev hovederne skåret af, så billedmodellen kopierer tøjet og aldrig låner den oprindelige models ansigt.

Fire udprintede produktbilleder af en kamelfarvet frakke, et koksgråt jakkesæt, en sort strikkjole og en stribet skjorte, alle skåret af under kraven, ved siden af en saks og papirstrimler
Billedet er genereret med AI: tøjreferencer skåret af under kraven, så kun tøjet føres over i masterbilledet.

Det afgørende er at holde op med at generere hvert sæt tøj fra bunden. Kun tøjet skifter. Sofaen, lampen, lyset og ansigtet er identiske på det godkendte masterbillede i hver version, og det er det, der får videoen til at ligne én person, der skifter tøj. Uden den konsistens ligner fire sæt tøj fire fremmede.

Trin 3: generér kamerabevægelsen ud fra et startbillede alene

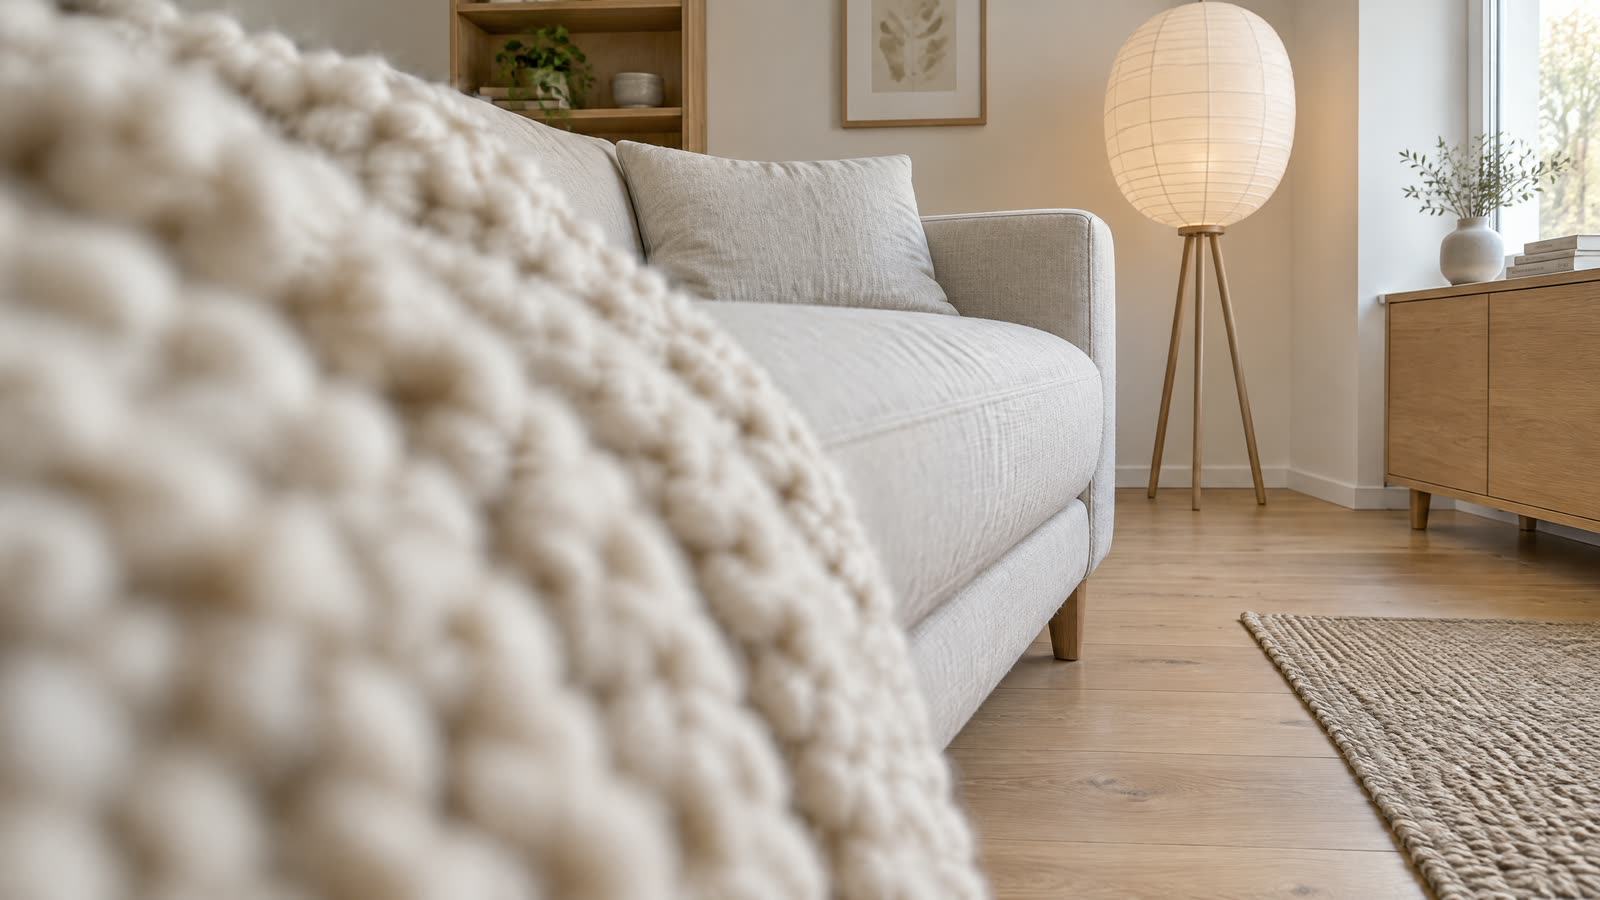
Hvert klip starter lavt ved enden af sofaen, bag et blødt strikket plaid, og kører op til billedet ovenfra. Den første version gav videomodellen både et startbillede og et slutbillede. Det slog fejl i begge de modeller, holdet prøvede, Wan 3.0 og Seedance 2.5.

Hvad hver opsætning af billeder gav i kranbevægelsen, som vist i AI Vidias film offentliggjort 1. november 2026
Billeder givetModelResultat
Start- og slutbilledeWan 3.0Blandede de to billeder sammen i en overtoning
Start- og slutbilledeSeedance 2.5Klippede direkte fra det ene billede til det andet
Kun startbilledeSeedance 2.5Byggede hele bevægelsen i én sammenhængende optagelse

Årsagen lå i materialet. Det lave startbillede og slutbilledet ovenfra beskrev ikke det samme fysiske rum, så ingen kamerabane kunne forbinde dem, og hver model faldt tilbage på en overgang. Med kun startbilledet havde Seedance 2.5 intet modstridende billede at ramme og byggede selv bevægelsen.

Arbejdsreglen er derfor: Giv kun en videomodel et slutbillede, når begge billeder viser det samme rum fra positioner, som et rigtigt kamera kunne bevæge sig imellem.

Trin 4: skjul hvert tøjskift i klipningen

Trenden, som filmen genskaber, skjuler hvert tøjskift i et kameradyk ind i en genstand tæt på linsen. Hvert klip slutter med at dreje ind i det strikkede plaid, og det næste begynder bag den samme sløring, så seeren aldrig ser tøjet skifte.

Et cremefarvet strikket plaid ude af fokus i forgrunden ved enden af en hørsofa med en papirlampe bagved
Billedet er genereret med AI: det bløde plaid i forgrunden, som hvert klip dykker ind i, og hvor tøjskiftet gemmer sig.

Hvert klip lander på et beat i musikken. Produktnavnene står små i en kursiv serif, så tøjet forbliver det største på skærmen. Hold det sådan.

Hvor AI-tøjet afviger fra det rigtige stykke tøj

Ingen prøvede tøjet på. Billedmodellen genskabte hvert stykke tøj ud fra flade produktbilleder, så pasform, fald og stoffets vægt er dens fortolkning. I filmen blev frakken en nuance lysere end produktet, og modellen tilføjede en butterfly, som jakkesættet ikke har.

Det er acceptabelt, når I tester en kreativ idé. En produktside stiller højere krav: En video, der viser tøjet anderledes end virkeligheden, lægger op til returneringer og vildleder køberne, så hvert billede skal tjekkes af et menneske mod den fysiske prøve, før videoen kommer derop. Brug tjeklisten, før en AI-modevideo går live.

TjeklisteFør en AI-modevideo går live

0 af 11 klaret

Identitet og samtykke
  • Hvert sæt tøj genereres ud fra dette billede, så ansigtet er det samme fra klip til klip

  • Det dækker de kanaler og den periode, annoncerne skal køre i

Tøjets nøjagtighed
  • Modellen kopierer tøjet og låner aldrig den oprindelige models ansigt

  • Sammenlign et billede med prøven i dagslys; en frakke en nuance for lys bliver afvist til en produktside

  • Kig efter lommer, knapper, bælter eller en butterfly, som produktet ikke har

Bevægelse
  • Tilføj kun et slutbillede, når begge billeder viser det samme fysiske rum

  • Afvis klip, der overtoner eller klipper midt i bevægelsen

Klipning
  • Klippet slutter i sløringen, og det næste starter bag den

  • Tøjet forbliver det største på skærmen

Mærkning
  • Påkrævet i EU, når personen ser ægte ud (AI-forordningen, artikel 50, stk. 4)

  • YouTubes indstilling for ændret eller syntetisk indhold; Meta viser AI info på annoncer lavet med Metas egne værktøjer

Hvem skal mærke en AI-modevideo i EU

Artikel 50 i EU's AI-forordning har gældt siden 2. august 2026, og den deler gennemsigtighedspligten i to. Udbydere af AI-værktøjer, der genererer billeder, lyd, video eller tekst, skal mærke resultatet i et maskinlæsbart format, så det kan genkendes som AI-genereret. Efter den digitale omnibus om AI har udbydere, hvis systemer allerede var på markedet før 2. august 2026, frist til 2. december 2026 til at opfylde mærkningspligten.

Den anden pligt ligger hos idriftsætteren, altså den virksomhed, der bruger AI-værktøjet til at lave indholdet. En AI-gengivelse af en virkelig person, som ville virke ægte for seerne, er en deepfake, og idriftsætteren skal oplyse, at den er AI-genereret, senest når folk ser den første gang. Den pligt har ingen overgangsperiode, som Morgan Lewis påpeger. Hele fordelingen af, hvem der mærker hvad, står i hvem der mærker AI-annoncer efter artikel 50.

Gennemgangsfilmen har sin AI-oplysning både i videoen og i YouTube-beskrivelsen. Platformene lægger deres eget lag ovenpå. YouTube kræver, at skabere oplyser realistisk ændret eller syntetisk indhold ved upload, og filmen har den mærkning slået til. Meta viser mærkatet "AI info" på annoncer, placeret ved siden af "Sponsoreret", når Metas egne generative værktøjer tilføjer en fotorealistisk person.

Sådan tester I AI-modevideoer mod jeres stillbilleder

Tag jeres ti bedst sælgende looks, og lav hvert af dem til en kort lodret film. Kør filmene mod jeres nuværende stillbilleder over for nye målgrupper i to uger, og behold stillbillederne i retargeting, indtil tallene siger noget andet. Det design følger dokumentationen ovenfor: video til dem, der aldrig har set brandet, og stillbilleder til dem, der allerede kender det.

AI Vidia kører den sammenligning som et fast forløb i Control Test: 10 annoncevarianter bygget mod jeres bedste nuværende annonce, målt i en test på 14 dage på ét måltal, som aftales på forhånd. Siden om AI-annoncer til modebrands viser formaterne til tøj, og produktionsforløbet beskriver kontrollerne, før noget bliver leveret.

Dagens opgave tager under 30 minutter. Åbn sidste måneds salgsrapport, skriv de ti looks ned, der solgte bedst, og tjek, at hvert af dem har et rent produktbillede forfra, som kan beskæres ved kraven. Den liste er jeres brief.

Ofte stillede spørgsmål

01Kan AI lave et produktbillede af tøj om til en video?
Ja. Brug produktbilledet, beskåret ved kraven, som tøjreference til en billedmodel, sæt tøjet på én godkendt person i en fast kulisse, og animér stillbilledet med en image-to-video-model som Seedance 2.5. Giv kun videomodellen et startbillede, medmindre begge billeder viser det samme fysiske rum.
02Hvor hurtigt kan man lave en AI-modevideo?
AI Vidias film på 16 sekunder med fire sæt tøj tog én arbejdsdag, uden filmhold, location eller model på settet. Hvert nyt look er en ny generering ud fra det samme masterbillede, så tiden pr. look falder, når personen og kulissen først er låst.
03Hvorfor skal modebrands bruge video i stedet for stillbilleder?
Video trækker køberen ind i oplevelsen af produktet: i laboratoriestudier i Journal of Marketing øgede video valget af den mest hedoniske mulighed med mere end 79 procent. Meta melder om rekordhøjt videoengagement på Facebook og Instagram. Stillbilleder vandt stadig på pris pr. køb i ATTN Agencys benchmarks fra marts 2026, så test begge.
04Viser AI-video, hvordan tøjet faktisk sidder?
Nej. Billedmodellen genskaber hvert stykke tøj ud fra flade billeder, så pasform, fald og stoffets vægt er dens fortolkning. I filmen blev frakken en nuance lysere, og jakkesættet fik en butterfly. Tjek hvert billede mod det rigtige stykke tøj, før videoen bruges på en produktside.
05Skal vi mærke AI-modevideoer?
Ja, når videoen viser en virkelig persons udseende på en måde, der ville virke ægte. Efter artikel 50 i EU's AI-forordning, der har gældt siden 2. august 2026, skal den virksomhed, der bruger AI-værktøjet, oplyse, at sådan en deepfake er AI-genereret. YouTube og Meta lægger deres egne AI-mærkater ovenpå.

Sådan har vi lavet artiklen

De fire trin, testene med start- og slutbilleder i tabellen og fejlene i tøjet er dokumenteret i AI Vidias film, der blev offentliggjort på YouTube den 1. november 2026; produktionens prompts blev ikke logget til artiklen. Alle kilder om platforme, forskning og lovgivning blev åbnet og læst den 2. november 2026, og tal gengives, som hver kilde angiver dem. ATTN's benchmarks er oplyst af bureauet uden offentliggjort metode eller datagrundlag.

Vi researcher og skriver udkast med hjælp fra AI, og vi tjekker tallene mod kilderne herunder.

Kilder

  1. 01Meta Platforms: First quarter 2026 earnings call transcript, 29 April 2026
  2. 02Roggeveen, Grewal, Townsend and Krishnan: The impact of dynamic presentation format on consumer preferences for hedonic products and services, Journal of Marketing 79(6), 34-49 (2015)
  3. 03ATTN Agency: Static vs video ads performance, 6 March 2026 (agency-reported Meta benchmarks)
  4. 04Segwise (Angad Singh): Static vs video ratio for Meta ads, 23 March 2026
  5. 05Wyzowl: Video Marketing Statistics 2026
  6. 06EUR-Lex: Regulation (EU) 2024/1689, the Artificial Intelligence Act (Articles 3, 50 and 113)
  7. 07EUR-Lex: Regulation (EU) 2026/1744, the Digital Omnibus on AI, Official Journal 24 July 2026 (Article 111(4))
  8. 08Morgan Lewis: EU AI Act's transparency rules: what went into effect on 2 August (August 2026)
  9. 09YouTube Official Blog: How we're helping creators disclose altered or synthetic content, 18 March 2024
  10. 10Meta: GenAI transparency in Meta's ads products, updated June 2026
  11. 11TechNode: ByteDance launches Seedance 2.5 video generation model, 31 July 2026
  12. 12Alibaba Cloud Community: Wan3.0, the new generation of Alibaba's Wan video generation model family (13 August 2026)

Næste skridt

Få et forslag til jeres næste annoncer.

Fortæl os om jeres produkt, målgruppe og behov for annoncer. Vi læser jeres brief og vender tilbage med et forslag til næste skridt.

Send jeres brief

Læs videre